Французский стартап Mistral выкатил предварительную версию своей новой флагманской языковой модели Mistral Large 4. Новинка получила 1 триллион параметров, из которых в каждом запросе задействуются 49 миллиардов активных нейронов. Разбираем результаты бенчмарков, особенности обучения на суперкомпьютере Blackwell и реальную выгоду для разработчиков.
Французы снова в гонке: что известно о гиганте на 1 триллион параметров
Компания Mistral объявила о релизе превью-версии своего крупнейшего архитектурного проекта — Mistral Large 4. В отличие от монолитных сетей, модель спроектирована по схеме смеси экспертов (Mixture of Experts). Из общего объема в 1 триллион параметров вычислительный градиент активирует лишь 49 миллиардов на каждый отдельный токен.
Обучение такой масштабной системы потребовало специализированной инфраструктуры. Модель тренировали на собственном кластере компании, состоящем из 3800 ускорителей NVIDIA Grace Blackwell. Использование последнего поколения чипов позволило провести полный цикл обучения и подготовить рабочий API за рекордные сроки.
Разработчики не стали копировать чужие подходы к релизу и выбрали двухэтапную стратегию. Сначала сообщество получает доступ к облачному интерфейсу для тестирования гипотез и нагрузки, а к концу месяца планируется полноценный релиз открытых весов. Для разработчиков это означает возможность развернуть гигантскую систему на собственном оборудовании или в закрытом контуре компании.
3800 чипов Blackwell и 38 баллов в тесте Artificial Analysis: разбор цифр
Главным показателем прогресса стал существенный скачок в независимых тестах производительности. На платформе Artificial Analysis модель Mistral Large 4 набрала 38 баллов. Для сравнения, предыдущее поколение Mistral Large 3, вышедшее в декабре прошлого года, демонстрировало скромный результат в 9 баллов.
| Модель | Общий объем параметров | Активные параметры | Оценка Artificial Analysis |
|---|---|---|---|
| Mistral Large 3 (декабрь) | Не разглашается | Не разглашается | 9 баллов |
| DeepSeek 4.1 Flash | 552 млрд | Динамические | ~39-40 баллов |
| Mistral Large 4 (превью) | 1 триллион | 49 млрд | 38 баллов |
Результат в 38 баллов выводит французскую разработку на одну дистанцию с китайской модели DeepSeek 4.1 Flash. Китайский конкурент с объемом 552 миллиарда параметров находится чуть впереди по общему индексу, однако Mistral Large 4 демонстрирует более высокий потенциал в специализированных сценариях генерации кода и структурированного текста.
По оценкам экспертов рынка, новый релиз сократил отставание Mistral от безусловных лидеров индустрии до шести месяцев. Хотя модель не относится к топовому «классу Fable», она возвращает европейского разработчика в первую категорию поставщиков нейросетевых решений.
Две скорости мыслей и работа с токенами: как работает новый API
В интерфейсе программирования Mistral API для новинки добавили специальный параметр управления режимом рассуждения (reasoning levels). Разработчикам доступны только два фиксированных пресета: «none» для прямой генерации без промежуточных шагов и «high» для глубинного логического анализа задачи.
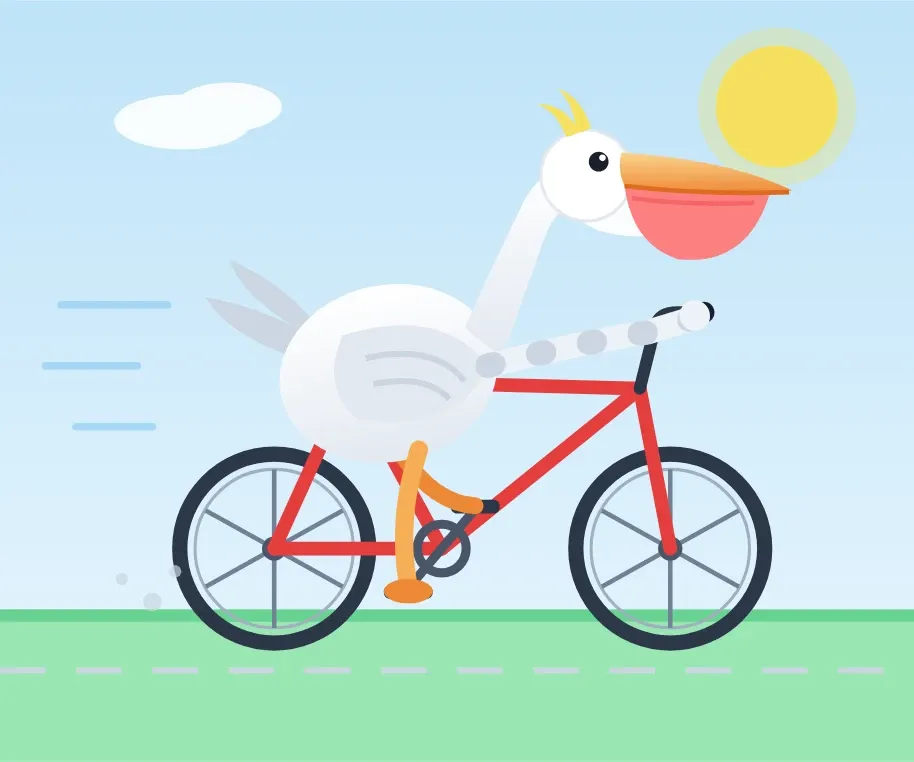
Тестирование на сложных текстовых и визуально-графических промптах показало любопытную аномалию расхода ресурсов. В тестовом задании с отрисовкой пеликана на велосипеде режим глубокого мышления «high» выдал гораздо более качественный результат, потратив при этом меньше генеративных токенов.
| Режим рассуждений в API | Качество исполнения | Расход выходных токенов |
|---|---|---|
| `none` (прямой ответ) | Базовое / посредственное | 3275 токенов |
| `high` (глубокий анализ) | Высокая детализация | 2717 токенов |
Парадокс заключается в том, что в режиме «high» модель тратит время на внутреннюю самопроверку, но формирует более лаконичный и точный итоговый ответ. В режиме «none» нейросеть начинает «галлюцинировать» словесным мусором и подбирать формулировки на ходу, из-за чего итоговый чек за токены оказывается выше.
Кому Mistral Large 4 пригодится на практике и где она уступает лидерам
Для продуктов и сервисов появление Mistral Large 4 означает доступ к высокопроизводительному текстовому движку без привязки к американской экосистеме. Архитектура с 49 миллиардами активных параметров обеспечивает быструю скорость инференса при сохранении глубокого контекста в 1 триллион параметров.
Главный выигрыш получают компании, планирующие запуск локальных LLM в контуре enterprise-систем. Ждать конца месяца однозначно стоит ради весов: после их публикации появится возможность запустить модель уровня DeepSeek 4.1 Flash на собственных серверах с картами NVIDIA.
Основные сферы применения новой модели на практике:
- Автоматическая генерация и рефакторинг кода в корпоративных IDE.
- Анализ больших объемов юридической и финансовой документации.
- Создание автономных агентов с логическим рассуждением в режиме
high. - Развертывание локальных серверов генеративного ИИ в закрытых корпоративных сетях.
Чего не хватает в анонсе и стоит ли ждать открытых весов в конце месяца
Несмотря на впечатляющий рост с 9 до 38 баллов в тестах, анонс Mistral оставляет ряд открытых вопросов. Разработчики пока не раскрыли точные требования к оборудованию для квантованных версий весов, которые выйдут в конце текущего месяца.
Кроме того, фиксированные режимы рассуждений в API без возможности точной настройки «температуры мышления» ограничат разработчиков в тонкой оптимизации стоимости запросов. Вариант «high» отлично экономит токены на сложных задачах, но для быстрых сценариев обработки диалогов может создавать ненужные задержки (latency) при формировании ответа.
Для разработчика это значит одно: прямо сейчас имеет смысл протестировать API на ваших рабочих промптах в обоих режимах рассуждения. Если показатели в бенчмарках подтвердятся на ваших данных, то к моменту релиза открытых весов в конце месяца у вас уже будет готовая архитектура для миграции с закрытых облачных сервисов.