Многие хотят помощника, который разбирается в личных документах, почте и календаре, но не отправляет данные в облако. Облачные сервисы стоят денег и бывают недоступны — локальная сборка на домашнем железе закрывает оба вопроса.
Главный вывод из опыта такой сборки: гнаться за самыми большими моделями не нужно. Для персонального ассистента хватает моделей на 9B–27B параметров. Полезной локальную модель делает не «чистый интеллект», а долговременная память, инструменты и доступ к реальному окружению пользователя.
Что должен уметь ассистент
Требования к системе в описанной сборке:
- работать с документами разных форматов, находить связи между ними и показывать их графически;
- взаимодействовать с внешним миром: Google (календарь, Gmail, Drive), Telegram — и как бот, и от имени владельца, внешние базы данных;
- накапливать знания и подстраиваться под пользователя;
- работать голосом на родном языке владельца: транскрибировать, обрабатывать текст моделью и переводить;
- быть автономным 24/7 и самому инициировать действия — например, считывать данные умного дома и датчиков.
Фокус — на агентских способностях, а не на замене облачного чат-бота. Модели крупнее 35B не нужны, а большую часть времени видеокарты простаивают. Это снижает требования к железу и энергопотреблению.
Железо: почему две карты, а не одна топовая
Десктопные платформы от рабочих станций отличает число линий PCIe: 24–28 против 64–128, при разнице в цене в 3–5 раз. Поэтому в домашнем ПК реалистичны одна или две видеокарты.
У связки из двух карт есть цена:
- обе работают в режиме x8/x8, и пропускная способность шины на карту падает вдвое: для PCIe 5.0 это 31,5 ГБ/с вместо 63 ГБ/с, для PCIe 4.0 x8 — около 15,75 ГБ/с;
- модель режется на две части (pipeline parallelism): сначала считается первая часть на одной GPU, данные уходят по шине, затем вторая часть — на другой, и на этом теряется ещё часть скорости;
- Windows использует один драйвер для обеих GPU, поэтому карты лучше брать одного поколения.
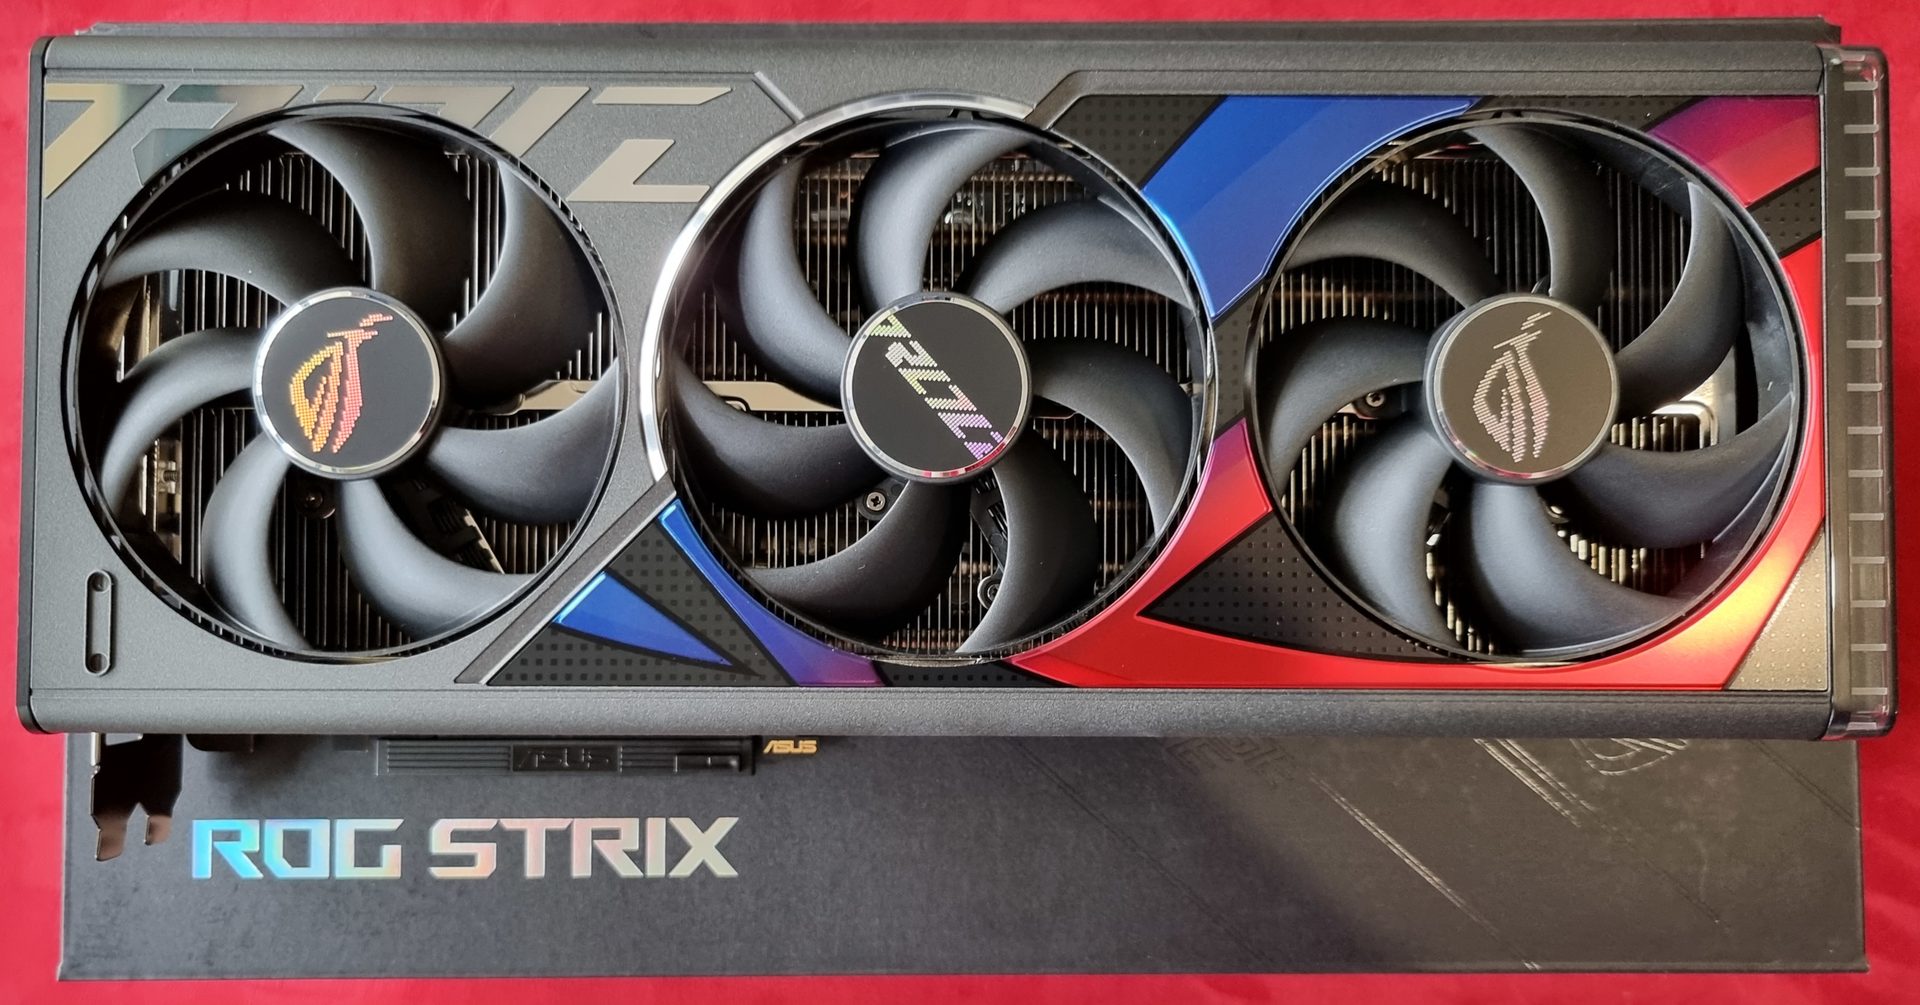
Топовые карты при этом невыгодны: RTX 5090 стоит примерно в 4 раза дороже 5080, а по производительности и объёму VRAM выигрывает меньше чем вдвое. Интереснее Ti/Super-версии 5060, 5070 и 5080: пара таких карт даёт до 48 ГБ VRAM.
Тестовая конфигурация
| Компонент | Что использовалось |
|---|---|
| ПК | два компьютера на i7 под Windows, 64 и 32 ГБ RAM, объединены в кластер |
| GPU | RTX 4070 Super и RTX 4070 Ti по 12 ГБ, всего 24 ГБ VRAM; плюс RTX 3080 на 10 ГБ |
| Блок питания | 850 Вт — оказалось достаточно |
| Варианты | обе 4070 в одном ПК и 3080 во втором; либо 4070 в разных ПК без 3080 |
Энергопотребление и охлаждение
Каждая 4070 в работе потребляла 110–120 Вт и не нагревалась выше 50–60 °C. Но при вертикальном корпусе тепло от нижней карты дополнительно греет верхнюю. Корпус лучше положить горизонтально и обеспечить интенсивный воздухообмен.
Ориентиры для более мощных пар при полной нагрузке:
| Конфигурация | Ожидаемое потребление |
|---|---|
| 2× RTX 5070 Ti | около 800 Вт |
| 2 карты уровня RTX 5080 | около 1 кВт |
| 2× RTX 5090 | около 1,5 кВт, нужно жидкостное охлаждение |
Без вычислений вся система потребляет 50–70 Вт.
Софт: anythingLLM как база
Для агентской части тестировались три фреймворка с разной философией: anythingLLM, crewAI и openClaw. Итог: одному пользователю нужен один агент, который меняет роли и выполняет цепочки глубиной 3–4 шага. Выбор пал на anythingLLM — работа с документами и RAG там уже реализована.
Модели запускались через Ollama и LM Studio: anythingLLM подключает оба как LLM-провайдеров. Скорость генерации у них заметно различается даже на одной и той же модели.
Какие модели запускать
Модели распределены по ролям:
| Роль | Размер модели |
|---|---|
| Микроагент для вызова функций | 0,4B–2B |
| Младший агент | 8B–9B |
| Средний агент | 12B–14B |
| Старший агент | 26B–32B |
Тестировались Qwen, Gemma, Ministral и другие. Контекст для работы с документами — 30–40 тыс. токенов. Результаты на паре 4070 Super + 4070 Ti (модель, как правило, делится между картами поровну):
| Модель, квантование | VRAM | Контекст | Скорость, ток/с |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-32B, Q4_K_S | 18,8 ГБ | 4k | 23,4 (LM Studio) |
| Qwen 27B, Q4_0 | 17–19 ГБ | 32k–50k | 27,3 (Ollama), 58,4 (LM Studio) |
| Qwen 27B, Q4_K_L | — | 32k | 54,3 (LM Studio) |
| Qwen 27B, UD-Q5_K_M | 19–22 ГБ | 4k–32k | 17,3–23,2 (Ollama) |
| Gemma-4-26B, Q4_K_M | 18 ГБ | 8k | 93,26 (Ollama) |
| Qwen3-14B, Q4_K_M | 15 ГБ | 32k | 48,8 (Ollama) |
| Qwen3.5-9B, Q5_K_M | 8,2 ГБ | 32k | 64,52 (Ollama) |
У 27B в Q5 при контексте 8k и 32k 5–7% модели уже уходит на CPU; целиком в видеопамять она влезает только с контекстом 4k. Для 27B-моделей в целом скорость комфортная — больше 25 ток/с.
Младшего агента вроде Qwen3.5-9B полностью хватает на управление инструментами, включая перевод. Он отвечает мгновенно, держит цепочки действий и помещается на одну 4070. Старшие модели на двух GPU дают более глубокий анализ: при построении дорожной карты по документу 9B предложила линейную структуру, а 27B — нелинейности, больше критических точек и замечаний.
Память: RAG плюс граф
Простого RAG мало — ассистент должен помнить связи между фактами. Поэтому памяти две:
- векторная — LanceDB, встроенная в anythingLLM;
- графовая — официальный MCP Memory server.
Агентский flow в anythingLLM записывает данные в обе памяти одновременно. Какие сущности, наблюдения и связи между ними сохранять, модель решает сама.
MCP-серверы в anythingLLM регистрируются в файле plugins/anythingllm_mcp_servers.json внутри каталога хранилища. Официальный сервер памяти подключается так (для npx нужен установленный Node.js):
{
  "mcpServers": {
    "memory": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-memory"]
    }
  }
}
Инструменты и интеграции
- Google Workspace (почта, календарь, Drive) — через google-workspace-mcp с авторизацией OAuth 2.0. OAuth-клиент для него создаётся в Google Cloud Console.
- Telegram — как бот и от имени пользователя. Бот пишет только о нештатных ситуациях, подробный отчёт присылает по запросу.
- Умный дом и датчики — через небольшой самописный MCP-сервер на Python для данных реального времени.
- Графика — Mermaid MCP вместо встроенного в anythingLLM генератора графиков на Recharts; для картинок — SD-Turbo-GGUF через Lemonade и Stable Diffusion Forge в Stability Matrix.
Свободно ходить по интернету агенту запрещено: к внешним сервисам он обращается только через прослойку MCP-серверов.
Голос и работа 24/7
- Распознавание речи — whisper-large-v3 через Lemonade: транскрибирует в реальном времени почти без задержки.
- Синтез речи — Piper через Speaches в Docker.
- Диктовка в сторонних программах — typeWhisper на тех же моделях Lemonade.
Весь AI-стек запускается одним BAT-файлом и работает в фоне, не мешая обычной работе за ПК.
Связка «транскрибер + LLM» оказалась самой востребованной: текст надиктовывается, модель убирает ошибки и переводит. Набор текста, по ощущениям владельца, ускоряется примерно в 10 раз. Голосовое управление календарём и брифинги по почте экономят по 10–15 минут на каждой такой задаче.
Подводные камни
- Ложные отчёты. Ассистент иногда сообщает, что задача выполнена, хотя инструменты даже не вызывал. Сверяйтесь со списком вызовов в системном чате. Возможное решение — дообученный микроагент для запуска инструментов под контролем младшего агента.
- Нет процедурной памяти. Агенты не запоминают удачные последовательности действий. Частично спасают workflow и skills для повторяющихся цепочек и журнал работы каждого агента в
.md, но нужен более формальный механизм. - Переполнение инструментов. Лишние инструменты забивают контекстное окно. Встроенный селектор может отключить нужный инструмент в неподходящий момент, поэтому его не используют: у агента только уникальные инструменты, часть объединена в skills.
- Промпт-инъекции. Защита от них — острая проблема. Неконтролируемые обновления всех инструментов исключены.
- Простой второй GPU. Если модель помещается на одну карту, вторая почти всё время простаивает.
Итоговая конфигурация
Для моделей до 27B достаточно одной карты с 24 ГБ VRAM или двух по 16 ГБ. При текущих ценах пара 16-гигабайтных карт выходит примерно вдвое дешевле одной топовой на 24 ГБ, а скорость 25–30 ток/с для диалога приемлема.
Установка заняла около недели, железо обошлось в ноль — использовалось то, что уже было. Похожие коммерческие сервисы стоят $20–40 в месяц. Заметного роста энергопотребления по сравнению с обычным использованием ПК не было.
Система на вырост — две карты 5070–5080 Ti/Super с суммарными 48 ГБ под 70B-модели, которые в отдельных задачах сопоставимы с ранними версиями GPT-4. Дальше цена прыгает ещё в 4–5 раз.
FAQ
Какая минимальная конфигурация видеокарт подойдёт?
Для моделей до 27B — одна карта на 24 ГБ или две по 16 ГБ. Описанная сборка работает на двух RTX 4070 по 12 ГБ, а младшей модели на 9B хватает и одной такой карты.
Нужно ли использовать именно anythingLLM?
Нет, но в нём уже есть работа с документами, RAG и агенты. crewAI и openClaw тоже тестировались, однако для одного пользователя хватило одного агента с цепочками в 3–4 шага.
Какие модели брать?
Модель на 9B вроде Qwen3.5-9B — для управления инструментами и перевода, 14B — для среднего уровня, 26–32B — для анализа документов. В квантовании Q4 старшие модели целиком помещаются в 24 ГБ двух карт; Q5 с длинным контекстом частично уходит на CPU.
Сколько энергии потребляет система?
Без нагрузки — 50–70 Вт на всю систему, в работе — 110–120 Вт на каждую 4070. Заметного роста потребления по сравнению с обычным использованием ПК не было.
Можно ли подключить умный дом?
Да. Для этого написан небольшой MCP-сервер на Python, который отдаёт агенту данные датчиков в реальном времени. О нештатных ситуациях ассистент сообщает через Telegram-бота.