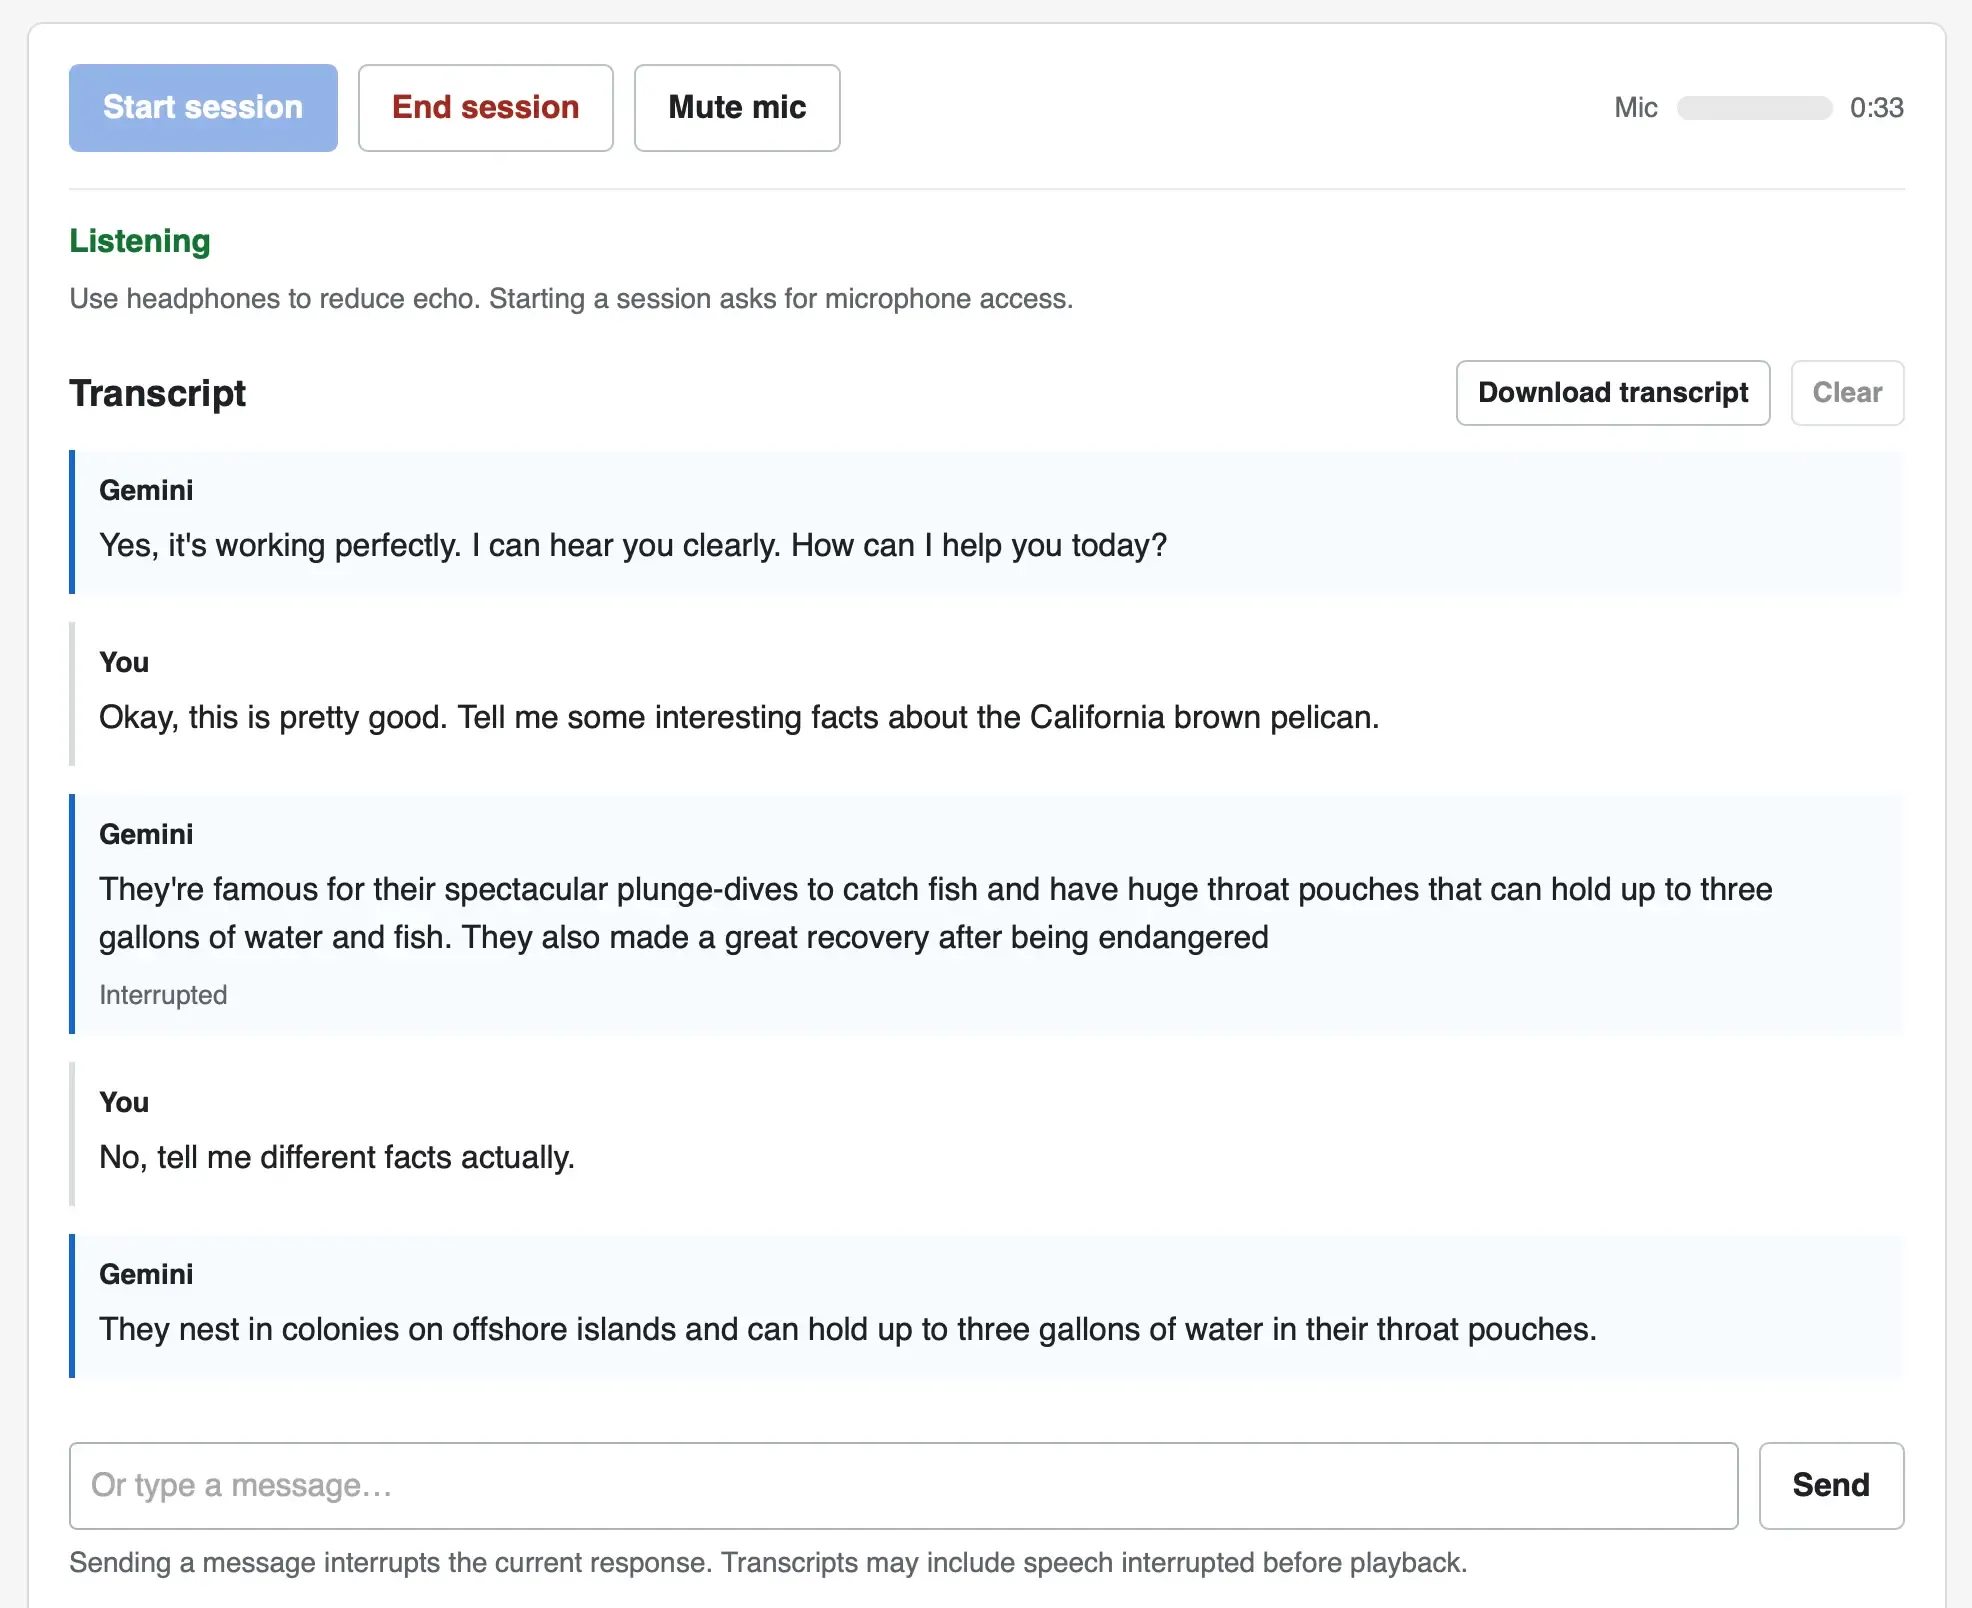
Google выпустила Gemini 3.8 Live и 3.8 Live Extended Thinking — речь идёт о двух новых speech-to-speech моделях, прямых конкурентах GPT-Live от OpenAI. Симон Уиллисон собрал рабочий веб-интерфейс для них без единой сторонней библиотеки — только браузерные API. Разбираем, как это устроено и как повторить самому.
Зачем это нужно и чем отличается от привычных подходов
Стандартный путь к голосовому боту выглядит так: берёшь SDK, подключаешь WebRTC-обёртку, добавляешь пару npm-пакетов — и получаешь 300 КБ зависимостей ради трёх функций. Gemini Live API позволяет обойтись без всего этого: браузер умеет работать с WebSocket и Web Audio API нативно.
Gemini 3.8 Live ориентирован на сценарии с низкой задержкой: голосовые агенты, диалоги в реальном времени, асинхронные вызовы инструментов прямо во время разговора. Extended Thinking — версия с reasoning-паузами, если нужна глубина ответа важнее скорости.
Что внутри: протокол и формат аудио
Вся коммуникация идёт через один WebSocket-эндпоинт:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=YOUR_API_KEYЭто двунаправленный (bidi) стриминг: браузер отправляет аудио-чанки, модель отвечает аудио-чанками в реальном времени. Прерывать модель на полуслове — поддерживается из коробки.
Формат аудио фиксированный:
| Параметр | Входящий поток (микрофон) | Исходящий поток (модель) |
|---|---|---|
| Формат | 16-bit PCM, little-endian | 16-bit PCM, little-endian |
| Частота дискретизации | 16 000 Гц | 24 000 Гц |
| MIME | audio/pcm | audio/pcm |
Захват микрофона и отправка через WebSocket
Для захвата используется AudioContext с ScriptProcessorNode (или современный AudioWorklet). Ниже — минимальный скелет захвата и отправки:
const ws = new WebSocket(
  `wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=${API_KEY}`
);

// Захват микрофона
const stream = await navigator.mediaDevices.getUserMedia({ audio: true });
const audioCtx = new AudioContext({ sampleRate: 16000 });
const source = audioCtx.createMediaStreamSource(stream);
const processor = audioCtx.createScriptProcessor(4096, 1, 1);

processor.onaudioprocess = (e) => {
  const float32 = e.inputBuffer.getChannelData(0);
  const int16 = convertFloat32ToInt16(float32); // см. ниже
  if (ws.readyState === WebSocket.OPEN) {
    ws.send(JSON.stringify({
      realtimeInput: {
        mediaChunks: [{
          mimeType: "audio/pcm",
          data: btoa(String.fromCharCode(...new Uint8Array(int16.buffer)))
        }]
      }
    }));
  }
};

source.connect(processor);
processor.connect(audioCtx.destination);
Конвертация Float32 → Int16 (браузер отдаёт float, API ждёт int16):
function convertFloat32ToInt16(buffer) {
  const int16 = new Int16Array(buffer.length);
  for (let i = 0; i < buffer.length; i++) {
    int16[i] = Math.max(-32768, Math.min(32767, buffer[i] * 32768));
  }
  return int16;
}
Воспроизведение ответа модели
Модель присылает аудио-чанки в base64. Их нужно декодировать и проиграть через второй AudioContext с частотой 24 000 Гц:
const playbackCtx = new AudioContext({ sampleRate: 24000 });

ws.onmessage = async (event) => {
  const msg = JSON.parse(event.data);
  const parts = msg?.serverContent?.modelTurn?.parts ?? [];

  for (const part of parts) {
    if (part.inlineData?.mimeType === "audio/pcm") {
      const raw = atob(part.inlineData.data);
      const int16 = new Int16Array(raw.length / 2);
      for (let i = 0; i < int16.length; i++) {
        int16[i] = raw.charCodeAt(i * 2) | (raw.charCodeAt(i * 2 + 1) << 8);
      }
      const float32 = new Float32Array(int16.length);
      for (let i = 0; i < int16.length; i++) {
        float32[i] = int16[i] / 32768;
      }
      const buffer = playbackCtx.createBuffer(1, float32.length, 24000);
      buffer.copyToChannel(float32, 0);
      const src = playbackCtx.createBufferSource();
      src.buffer = buffer;
      src.connect(playbackCtx.destination);
      src.start();
    }
  }
};
Системный промпт и выбор модели
Перед началом диалога нужно отправить setup-сообщение сразу после открытия WebSocket:
ws.onopen = () => {
  ws.send(JSON.stringify({
    setup: {
      model: "models/gemini-3.8-live-001", // или gemini-3.8-live-extended-thinking-001
      systemInstruction: {
        parts: [{ text: "Ты голосовой ассистент. Отвечай кратко." }]
      },
      generationConfig: {
        responseModalities: ["AUDIO"],
        speechConfig: {
          voiceConfig: {
            prebuiltVoiceConfig: { voiceName: "Aoede" } // выбор голоса
          }
        }
      }
    }
  }));
};
Модели на выбор: gemini-3.8-live-001 для минимальной задержки, gemini-3.8-live-extended-thinking-001 когда важнее качество рассуждений. Поддерживается 97 языков с автоматическим переключением в процессе разговора.
Где ломается
Два AudioContext с разными sampleRate. Браузер создаёт AudioContext с частотой по умолчанию (обычно 44 100 или 48 000 Гц), если не передать sampleRate явно. Результат — искажённый звук в обе стороны.
ScriptProcessorNode устарел. Спецификация Web Audio API помечает его как deprecated. В продакшене лучше использовать AudioWorklet, но это требует отдельного JS-файла для воркера и усложняет архитектуру.
btoa и бинарные данные. String.fromCharCode(...new Uint8Array(...)) падает на больших буферах из-за лимита стека. Для чанков от 4096 сэмплов это критично — нужен цикл с apply или TextDecoder.
Прерывание модели. Чтобы прервать ответ модели, нужно отправить специальное сообщение { clientContent: { turnComplete: true } }. Просто перестать слать аудио недостаточно.
CORS и ключ API в браузере. API-ключ оказывается в исходном коде на клиенте. Для прототипа это приемлемо, для продакшена — нет: нужен прокси на сервере.
Что попробовать дальше
Официальный туториал по Live API с WebSocket доступен в документации Google AI for Developers — там разобраны асинхронные вызовы функций и передача видеопотока. Если нужна поддержка видео с камеры или шаринг экрана, Live API это поддерживает нативно: модель обрабатывает видео почти в реальном времени и учитывает его в контексте ответа. Для production-сценариев стоит посмотреть на Firebase AI Logic — там уже есть обёртки с управлением сессиями.
FAQ
Чем Gemini 3.8 Live отличается от Extended Thinking?
Gemini 3.8 Live оптимизирован для минимальной задержки — подходит для диалоговых агентов, где важна скорость реакции. Extended Thinking делает паузу на reasoning перед ответом, что даёт более взвешенные ответы на сложные вопросы, но увеличивает время отклика.
Нужен ли сервер для работы с Live API?
Для прототипа — нет, браузер подключается к WebSocket напрямую. Но API-ключ будет виден в клиентском коде, поэтому для продакшена нужен серверный прокси.
Какие форматы аудио принимает Live API кроме PCM?
API также принимает audio/wav и audio/mp3, но нативный формат для стриминга — audio/pcm (16-bit, little-endian, 16 кГц на вход, 24 кГц на выход).
Можно ли прерывать модель во время ответа?
Да, это поддерживается из коробки. Нужно отправить сообщение { clientContent: { turnComplete: true } } — модель остановит воспроизведение и перейдёт к обработке нового ввода.
На скольких языках работает Gemini 3.8 Live?
Модель поддерживает 97 языков и автоматически определяет язык пользователя в процессе разговора, переключаясь без явной команды.

